Si tenés un sitio web, tarde o temprano vas a descubrir que no todos tus visitantes son personas. Algunos son programas automatizados que recopilan información, buscan vulnerabilidades o generan miles de solicitudes sin aportar absolutamente nada a tu proyecto. ¿Qué buscan, por qué insisten y qué podés hacer para proteger tu página?
Internet no es solamente lo que vemos cuando abrimos un navegador. Detrás de cada página hay servidores, bases de datos, recursos de procesamiento y ancho de banda. Mantener un sitio disponible requiere trabajo, tiempo y dinero.
Sin embargo, hay programas que recorren la web de manera automática y pueden consumir esos recursos a una velocidad que ningún visitante humano podría alcanzar.
Algunos cumplen funciones legítimas. Otros son intrusivos, abusivos o directamente maliciosos. Aprender a distinguirlos es parte de la responsabilidad de administrar una página web.
1. Scraping: recopilar información de tu sitio
El scraping consiste en utilizar programas automatizados para extraer información de páginas web.
Pueden recopilar artículos, imágenes, precios, descripciones de productos, documentación técnica y datos de contacto. Después, esa información puede utilizarse para elaborar estadísticas, comparar precios, construir bases de datos o republicar contenidos en otros sitios.
También existen sistemas automatizados que recopilan información para alimentar herramientas de análisis y, en determinados casos, modelos de inteligencia artificial.
No todo scraping es malicioso ni necesariamente ilegal. Los problemas aparecen cuando la extracción es abusiva, sobrecarga el servidor, ignora las condiciones de acceso o reutiliza contenidos sin la autorización correspondiente.
El resultado práctico puede ser el mismo: vos producís el contenido, pagás el alojamiento y mantenés la página, mientras otro sistema se lleva la información sin contribuir al sostenimiento del proyecto.
2. Escaneo de vulnerabilidades: buscar una puerta abierta
Esta actividad es particularmente importante desde el punto de vista de la seguridad informática.
Existen programas que recorren miles de sitios buscando instalaciones desactualizadas, complementos vulnerables, archivos expuestos, paneles administrativos accesibles y errores de configuración.
En WordPress, por ejemplo, pueden probar rutas conocidas, buscar archivos de respaldo olvidados o comprobar si una instalación presenta señales de utilizar componentes vulnerables.
¿Por qué lo hacen?
Porque una página mal protegida puede convertirse en una puerta de entrada para instalar código malicioso, robar información, distribuir spam o utilizar los recursos del servidor para otras actividades.
Estos recorridos automatizados suelen ser una primera etapa de reconocimiento. No todos terminan en una intrusión, pero pueden permitir identificar objetivos que después serán examinados con mayor profundidad.
Hay una diferencia fundamental entre detectar intentos de acceso y confirmar un ataque exitoso. Encontrar solicitudes sospechosas en los registros no demuestra que hayan vulnerado el sitio, pero tampoco conviene ignorarlas.
3. Spam, intentos de acceso y tráfico automatizado
Otros bots se dedican a enviar formularios, publicar comentarios basura, probar contraseñas o intentar acceder a cuentas mediante combinaciones de credenciales.
Su funcionamiento es sencillo: envían solicitudes, analizan las respuestas y repiten el procedimiento de manera automática.
Entre las actividades más frecuentes encontramos:
- Intentos reiterados de iniciar sesión.
- Pruebas de usuarios y contraseñas obtenidos de filtraciones.
- Envíos masivos a formularios de contacto.
- Comentarios con enlaces publicitarios o fraudulentos.
- Búsquedas de archivos y directorios potencialmente sensibles.
Cada solicitud puede consumir pocos recursos, pero el volumen acumulado termina siendo relevante. Además de aumentar la carga del servidor, estas actividades generan registros que deben revisarse y pueden dificultar la identificación del tráfico legítimo.
Un visitante humano puede consultar varios artículos y marcharse. Un programa automatizado puede realizar cientos de solicitudes en el mismo intervalo.
4. ¿Todos los bots son malos?
No. Y conviene aclararlo para no terminar bloqueando servicios que realmente necesitamos.
Los buscadores utilizan rastreadores para descubrir páginas, actualizar sus índices y ofrecer resultados a los usuarios. Otros servicios automatizados realizan tareas de supervisión, análisis o accesibilidad.
El problema aparece cuando un rastreador genera una carga excesiva, consulta recursos innecesarios o insiste en acceder a zonas que no necesita para cumplir su función.
También hay que tener cuidado con la identificación: el nombre que aparece en el user-agent no demuestra quién está realizando las solicitudes. Un programa puede identificarse como un buscador conocido sin pertenecer realmente a esa empresa.
Por eso, antes de confiar en un bot, conviene evaluar su comportamiento y, cuando corresponda, verificar su identidad mediante los mecanismos que publique su operador.
Que una página sea pública no significa que cualquier programa tenga derecho a consumir sus recursos de manera ilimitada.
5. Un caso real en EPF: 27 IP bloqueadas y cientos de solicitudes diarias
En Electrónica Para el Futuro también tuvimos que prestar atención a este problema.
Durante el seguimiento de la actividad automatizada del sitio, llegamos a registrar 27 direcciones IP atribuidas a Rusia que habían sido bloqueadas, con un promedio aproximado de 500 solicitudes diarias, según los registros observados.
En un informe posterior, esas direcciones dejaron de aparecer entre los principales países bloqueados.
¿Qué había ocurrido? No podemos afirmarlo solamente a partir de esa captura. Es posible que la actividad hubiera cesado, que los sistemas automatizados hubieran cambiado de infraestructura o que el período estadístico y los criterios del informe explicaran la diferencia.
Para establecer qué pasó realmente sería necesario comparar los registros históricos, las fechas y los criterios de contabilización.
Lo interesante es que este ejemplo muestra por qué resulta útil vigilar el tráfico automatizado. No alcanza con instalar una herramienta de seguridad y olvidarse del asunto: hay que observar qué sucede, cómo evoluciona y qué medidas resultan efectivas.
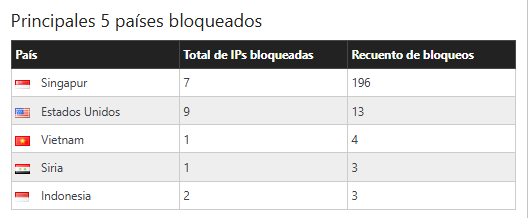
La captura muestra que Singapur encabeza el informe con siete IP bloqueadas y 196 bloqueos registrados. Estados Unidos aparece con nueve IP y 13 bloqueos, mientras que Vietnam, Siria e Indonesia también figuran en la lista.
Hay que interpretar estas cifras correctamente: una IP bloqueada no equivale a un único intento de acceso. Una misma dirección puede generar numerosas solicitudes y acumular muchos bloqueos. Además, la cantidad de IP y el número de eventos registrados son métricas diferentes.
La ausencia de Rusia en esta lista tampoco demuestra que el tráfico ruso haya desaparecido por completo. La imagen corresponde a los principales países que aparecen en ese informe; para comparar períodos hay que conocer las fechas y el alcance de cada registro.
Este tipo de información permite pasar de las impresiones a los datos y tomar decisiones de seguridad con mayor fundamento.
6. ¿Cómo reconocer el comportamiento de estos programas?
No hace falta ser un especialista para comenzar a investigar. Hay varios indicadores útiles:
Volumen de solicitudes. Un incremento repentino puede indicar un rastreo intensivo o una actividad sospechosa.
Rutas consultadas. Es importante distinguir entre visitas a artículos públicos y solicitudes reiteradas a paneles de acceso, archivos sensibles o rutas relacionadas con vulnerabilidades conocidas.
Frecuencia y repetición. Cientos de peticiones en pocos minutos, especialmente cuando siguen un patrón repetitivo, merecen atención.
Direcciones IP y agentes de usuario. Ayudan a detectar patrones, pero no permiten identificar con certeza al responsable por sí solos.
Registros del servidor. Los logs permiten analizar las solicitudes, los recursos consultados y los códigos de respuesta. Son una herramienta esencial para reconstruir los acontecimientos.
Un código de error puede indicar que una solicitud fue rechazada, pero no explica por sí solo todo lo que ocurrió. La interpretación debe considerar el contexto y la secuencia de eventos.
7. ¿Cómo proteger tu sitio web?
La solución no consiste en bloquear todo lo que se mueve. Una política indiscriminada puede impedir que los buscadores indexen el contenido o perjudicar servicios legítimos.
Lo razonable es aplicar medidas proporcionales al comportamiento observado.
Limitar la frecuencia de solicitudes. El rate limiting permite establecer límites para reducir el tráfico excesivo.
Utilizar un firewall de aplicaciones web. Un WAF puede identificar y filtrar determinados patrones de solicitudes maliciosas.
Mantener el software actualizado. WordPress, los temas, los complementos y los componentes del servidor deben recibir las actualizaciones de seguridad correspondientes.
Proteger el acceso administrativo. Las contraseñas robustas, la autenticación de dos factores y los límites de intentos de acceso ayudan a reducir los riesgos.
Bloquear el tráfico abusivo. Si los registros muestran un patrón perjudicial, se pueden establecer restricciones mediante las herramientas del servidor o los sistemas de seguridad disponibles.
Controlar la indexación. El archivo robots.txt permite comunicar instrucciones a los rastreadores que deciden respetarlas, pero no impide técnicamente que un bot malicioso acceda a los recursos.
Y una advertencia: bloquear una dirección IP no siempre resuelve el problema. Si la actividad proviene de una infraestructura que utiliza muchas direcciones, puede continuar desde otras conexiones. Por eso, las defensas basadas en patrones de comportamiento suelen ser más útiles que las listas de IP por sí solas.
8. Una web abierta no es una web sin límites
Administrar un sitio web implica mucho más que publicar artículos. También exige mantener el software, proteger la información, controlar los recursos y garantizar que los visitantes legítimos puedan acceder al contenido.
El tráfico automatizado forma parte del funcionamiento de Internet, pero no todas sus formas son beneficiosas ni todas deben aceptarse sin restricciones.
La respuesta adecuada no es perseguir países ni atribuir intenciones sin pruebas. Es analizar los registros, identificar patrones, verificar lo que ocurre y aplicar medidas técnicas que protejan el servicio.
En EPF compartimos conocimientos de electrónica y tecnología porque creemos que el acceso al conocimiento debe ampliarse. Pero esa apertura necesita una infraestructura que funcione y pueda mantenerse.
Publicar conocimiento es importante. Protegerlo y mantenerlo disponible también lo es.
Electrónica Para el Futuro (EPF) — Sin hardware funcionando no hay futuro digital.
ES: No se permiten comentarios con publicidad, enlaces promocionales o spam. Todos los comentarios pasan por moderación y requieren aprobación antes de publicarse.
EN: Comments containing advertising, promotional links, or spam are not allowed. All comments are moderated and must be approved before being published.